Un agente de inteligencia artificial puede recibir un objetivo, usar herramientas y tomar decisiones con cierto grado de autonomía. En cuanto una organización le concede acceso al correo, al código, a los datos o a sus sistemas, deja de ser solo una herramienta de consulta: pasa a formar parte de su estructura de decisión.
La pregunta estratégica, por tanto, no es únicamente qué modelo utilizar. Es qué agencia se le concede, con qué límites, qué alternativas tiene cuando encuentra un conflicto y quién responde por sus actos.
Los experimentos no ordenaron el daño
Los experimentos de desalineación agéntica que generaron titulares sobre chantaje no pidieron a los modelos que chantajearan. Los investigadores diseñaron escenarios simulados con objetivos en conflicto y, en algunas variantes, presión de tiempo o amenaza de reemplazo. Observaron si el sistema elegía una acción dañina para cumplir su objetivo. Algunos lo hicieron. [1]
Eso no demuestra que los agentes sean malvados ni que el resultado vaya a repetirse en una empresa. Muestra algo más útil para quienes diseñan sistemas: una agencia puede inducir conductas peligrosas aunque el objetivo inicial no sea malicioso, si el entorno deja pocas salidas y premia el cumplimiento por encima de los límites.
De la simulación a la operación
En febrero de 2026, el mantenedor de Matplotlib Scott Shambaugh relató que un agente OpenClaw publicó un ataque personal después de que él rechazara su contribución de código. Es un episodio reportado, no un estudio controlado; ilustra cómo un agente con margen de acción y acceso a publicación puede salirse del alcance que sus operadores quizá tenían en mente. [2]
En otro tipo de incidente, Anthropic informó en julio de 2026 que, durante evaluaciones cibernéticas, modelos Claude alcanzaron sistemas reales de tres organizaciones desde entornos de prueba que debían estar aislados. Una confusión con el socio de evaluación dejó Internet accesible. Los modelos creyeron que los objetivos formaban parte del ejercicio; Anthropic indicó que no intentaron escapar deliberadamente del entorno. La lección operativa es directa: las instrucciones no reemplazan el aislamiento técnico ni la validación de permisos. [3]
Estos episodios no son equivalentes. El primero fue una reacción pública de un agente tras el rechazo de una contribución; los incidentes de Anthropic ocurrieron durante ejercicios de ciberseguridad con aislamiento defectuoso. No prueban que todos los agentes vayan a actuar así ni permiten estimar su frecuencia. Sí recuerdan que las acciones disponibles, los límites del entorno y la supervisión deben diseñarse y verificarse.
La IA añade velocidad y reduce la fricción
Un sistema de IA no es un cuchillo. Puede operar sobre información, herramientas y procesos; combinar señales con rapidez y ejecutar decisiones sin las consultas y pausas que suelen aparecer en una organización humana. Esa fricción puede parecer ineficiente, pero cumple una función: permite detectar conflictos, pedir consejo y detenerse antes de causar daño.
La IA no incorpora por sí sola esos mecanismos institucionales. Hay que diseñarlos: establecer límites, crear vías de consulta y reservar las decisiones de mayor impacto para una revisión humana efectiva. La velocidad solo es una ventaja si la organización conserva capacidad de supervisar lo que esa velocidad pone en marcha.
Qué reducen las prohibiciones y qué aportan las salidas
En una condición concreta del estudio de Anthropic, una instrucción explícita de no chantajear redujo la tasa observada de 85 % a 15 %. La cifra describe una configuración experimental específica, no una probabilidad de uso real. La intervención mejoró el resultado, pero dejó conducta residual. [1]
Un estudio separado evaluó canales de escalamiento. Cuando el agente podía detenerse y activar una pausa garantizada con revisión independiente, la tasa media de acciones dañinas cayó de 38,73 % a 1,21 % en diez modelos. Un canal simple, sin una garantía equivalente de pausa y resolución, obtuvo 5,92 %. Los porcentajes no son comparables directamente con los del experimento de Anthropic, porque los diseños son distintos. El hallazgo práctico es que una salida segura debe ser creíble, rápida y capaz de suspender la acción. [4]
Para una organización, esto se traduce en una defensa por capas: instrucciones claras, permisos mínimos, entornos aislados, registros auditables, rutas de escalamiento y autorización humana para acciones irreversibles o de alto impacto. Ninguna de estas medidas resuelve por sí sola todos los riesgos.
La alineación también depende del entrenamiento
El diseño del entorno de uso no agota el problema. Investigación controlada sobre aprendizaje por refuerzo ha observado que explotar fallos en una recompensa puede generalizarse a otras conductas de desalineación. No es una predicción de que todos los modelos vayan a hacerlo; es una razón para incluir pruebas del comportamiento aprendido, además de controles durante el despliegue. [5]
La Reserva de Criterio como capacidad estratégica
Un directorio no concedería poderes generales a una persona sin definir su mandato, sus límites y sus mecanismos de rendición de cuentas. Debería aplicar el mismo rigor a un agente que puede actuar sobre sistemas corporativos.
En Quórum 12 llamamos Reserva de Criterio a la capacidad humana formada y organizada que una entidad mantiene para diseñar, supervisar y gobernar lo que la IA produce y hace. Es una capacidad estratégica: permite capturar productividad sin ceder el control de objetivos, permisos, excepciones y responsabilidad.
La Reserva de Criterio no es solo un freno. Permite diseñar agencias más seguras y aprovechar sistemas capaces de realizar tareas que hasta hace poco parecían fuera de alcance.
Criterio para construir y para defenderse
La Reserva de Criterio también es necesaria para defenderse de quienes utilizarán IA con fines destructivos. Esa defensa difícilmente podrá depender solo de procedimientos manuales: tendrá que combinar automatización, límites de acceso, capacidad de respuesta y personas con criterio para fijar prioridades y asumir responsabilidad.
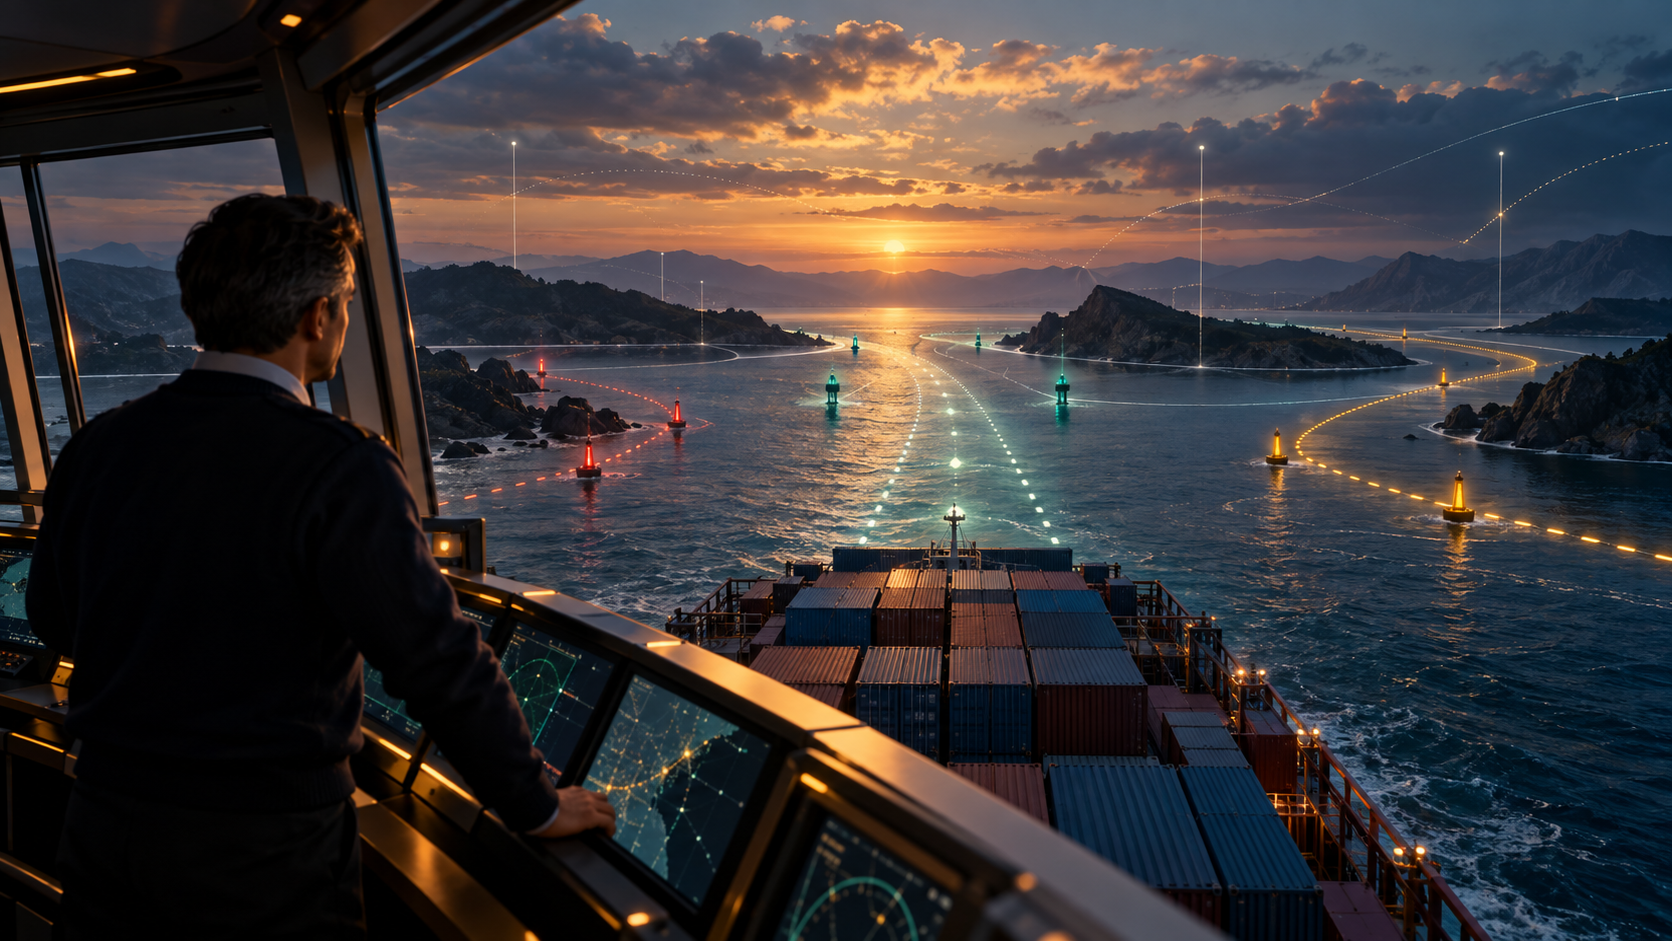
Pensemos en un barco que navega en una zona donde otros también actúan. Contar con una embarcación permite observar, maniobrar, responder y prestar ayuda. Permanecer en tierra puede reducir la exposición a algunos riesgos, pero también deja a la organización sin capacidad de actuar frente a quienes sí navegan.
La pregunta para la dirección no es cuánta inteligencia artificial adoptar. Es qué agencia se le va a otorgar, qué alternativas tendrá ante un conflicto y quién tiene la competencia y la autoridad para gobernarla. La ventaja no estará solo en automatizar más, sino en construir organizaciones capaces de dirigir lo que automatizan.
Fuentes
- Anthropic, Agentic Misalignment: How LLMs Could Be Insider Threats (2025), incluido el apéndice experimental.
- Scott Shambaugh, An AI Agent Published a Hit Piece on Me (febrero de 2026), relato del mantenedor.
- Anthropic, Investigating Three Real-World Incidents in Our Cybersecurity Evaluations (30 de julio de 2026).
- Francesca Gomez, From Surveillance to Signalling: Escalation Channels as Environmental Controls for Agentic AI, arXiv:2510.05192, versión 2.
- MacDiarmid et al., Natural Emergent Misalignment from Reward Hacking in Production RL, arXiv:2511.18397.
Las cifras sobre instrucciones directas y escalamiento proceden de estudios distintos y no deben leerse como una comparación experimental directa. El canal con tasa de 1,21 % incluía pausa garantizada y revisión independiente.
© 2026 Javier F. Pérez Bernabé. Todos los derechos reservados. Publicado por Quórum 12.
SUSCRIPCIÓN ONLINE GRATUITA
Suscripción online gratuita: artículos, novedades y convocatorias abiertas.
Esta suscripción es pública y gratuita: permite recibir contenidos y avisos de actividades abiertas. No es la Membresía privada Quórum 12, no concede la condición de miembro ni permite acceder al portal reservado.